Machine Learning promete anticipar fallas, detectar anomalías, optimizar procesos y ayudar a las plantas industriales a tomar mejores decisiones. Pero existe una pregunta que debería hacerse antes de seleccionar algoritmos, plataformas o proveedores:
¿Está realmente su planta preparada para utilizar Machine Learning?
Para un responsable de Mantenimiento, Operaciones o Producción, estar preparado no significa disponer de enormes cantidades de datos ni tener todas las máquinas equipadas con sensores de última generación.
Significa algo mucho más práctico: tener un problema industrial suficientemente importante, disponer de datos relacionados con ese problema y poder convertir las predicciones del modelo en decisiones operativas.
Los datos son precisamente uno de los principales desafíos para implementar Machine Learning en entornos industriales. No basta con acumular información: importan su calidad, continuidad, contexto y capacidad para representar lo que realmente ocurre en el proceso.
Estas 7 preguntas permiten realizar una primera evaluación de la preparación de una planta para implementar Machine Learning industrial.
1. ¿Existe un problema operativo concreto que queremos resolver?
El primer error es comenzar por la tecnología: “Queremos implementar Inteligencia Artificial industrial”
La pregunta debería formularse al revés: ¿Qué problema de Mantenimiento, Producción u Operaciones queremos resolver mejor gracias a los datos?
El Machine Learning necesita un objetivo operacional.
Por ejemplo:
- Anticipar la falla de un rodamiento crítico.
- Detectar comportamientos anormales en una prensa.
- Predecir defectos de calidad.
- Identificar condiciones que provocan microparos.
- Optimizar parámetros de proceso.
- Predecir consumo energético.
- Identificar patrones asociados con pérdida de productividad.
Cuanto más específico sea el problema, más sencillo será determinar qué datos necesitamos y cómo medir el resultado.
“Predecir fallas” es demasiado amplio.
“Detectar con anticipación la degradación del rodamiento del motor principal de una línea cuya falla provoca seis horas de paro” ya define un caso de uso sobre el que se puede trabajar.
La primera señal de preparación para Machine Learning, por tanto, no es disponer de datos: es tener un problema de negocio claramente definido.
2. ¿Sabemos qué equipos y procesos son realmente críticos?
No todos los activos justifican la misma inversión en monitoreo o análisis de datos.
Una máquina puede presentar numerosas fallas y, sin embargo, tener poca importancia si existe redundancia, su reparación es rápida o no afecta significativamente a producción.
Otra puede fallar pocas veces, pero cada evento detener toda una línea durante horas.
Por eso, antes de decidir dónde aplicar Machine Learning industrial, conviene evaluar variables como:
Criticidad del activo, frecuencia de fallas, MTBF (Mean Time Between Failures – Tiempo Medio Entre Fallas ) , MTTR (Mean Time To Repair – Tiempo Medio de Reparación o de Recuperación) , redundancia, tiempo de paro, producción afectada y costo económico de la indisponibilidad.
El objetivo es encontrar dónde coincide:
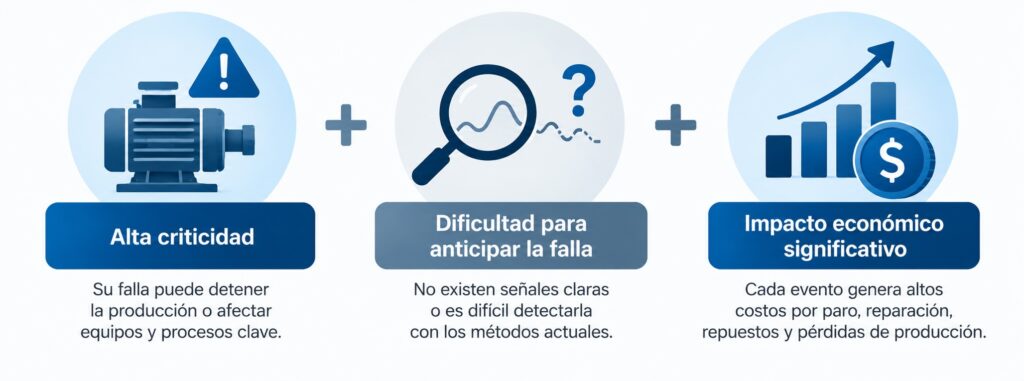
Carsan Technology utiliza precisamente una Matriz de Criticidad vs. Cobertura de Monitoreo para identificar activos críticos, evaluar su nivel actual de monitoreo y determinar cuáles pueden ser candidatos iniciales para mantenimiento predictivo o Machine Learning.
Antes de desarrollar un modelo sofisticado, hay que asegurarse de estar intentando predecir algo que realmente merece la pena predecir.
3. ¿Tenemos datos sobre lo que está ocurriendo en la máquina o proceso?
Una vez identificado el problema, llega una pregunta fundamental:
¿Podemos observarlo a través de los datos?
Una planta puede disponer de PLC, SCADA, sensores, históricos, alarmas y sistemas de mantenimiento, pero eso no significa automáticamente que tenga los datos necesarios para desarrollar un modelo.
Dependiendo del caso de uso pueden necesitarse variables como:
Vibración, temperatura, presión, corriente, torque, velocidad, ciclos, tiempos de operación, alarmas, setpoints, estados de máquina o parámetros de proceso.
El objetivo es seleccionar las variables que puedan aportar información sobre el problema y comprobar su utilidad
Es determinar:
¿Qué señales cambian cuando comienza a aparecer el problema que queremos anticipar?
Por ejemplo, si queremos detectar degradación en determinados componentes mecánicos, la evolución de la vibración y la temperatura podría aportar información relevante.
Si queremos predecir problemas de proceso, probablemente necesitaremos combinar diferentes variables operativas.
El Machine Learning necesita señales relacionadas con el fenómeno que queremos identificar.
4. ¿Tenemos suficiente histórico y calidad de datos?
Disponer de sensores es diferente de disponer de datos utilizables.
Los datos industriales pueden presentar huecos, ruido, cambios de sensor, errores de timestamp, diferentes frecuencias de muestreo o periodos asociados con diferentes condiciones de funcionamiento.
La investigación sobre Machine Learning aplicado a manufactura identifica precisamente problemas de calidad, escasez y desequilibrio de datos entre los principales obstáculos para su implementación industrial.
Antes de entrenar un modelo conviene revisar:
- ¿Desde cuándo se registra la información?
- ¿Existen periodos sin datos o mediciones incorrectas?
- ¿Las fechas y horas están sincronizadas entre sistemas?
- ¿Se conocen las unidades y frecuencias de muestreo?
- ¿Hubo cambios de sensor, equipo o configuración?
- ¿Están representadas las condiciones de operación que queremos evaluar?
- ¿Podemos relacionar las señales con eventos reales?
No existe una cantidad universal de meses o años que garantice que una planta está preparada. Dependerá de la frecuencia de los eventos que queremos estudiar y de la variabilidad del proceso.
Un año de datos puede ser insuficiente si durante ese periodo nunca ocurrió la falla que queremos predecir.
Por eso, más datos no significa necesariamente mejores datos.
5. ¿Sabemos qué estaba ocurriendo cuando se generaron esos datos?
Esta pregunta suele separar una base de datos de una base de conocimiento industrial.
Supongamos que un motor presenta una vibración significativamente superior a su comportamiento habitual.
¿Existe una falla?
No necesariamente.
Podría estar trabajando con mayor carga, produciendo otra referencia o encontrarse en una condición operacional diferente.
El modelo necesita contexto.
Idealmente, deberíamos poder relacionar las variables con información como:
Producto fabricado, velocidad, carga, turno, receta, modo de operación, arranque, parada, mantenimiento realizado, cambio de herramienta o evento de falla.
Esta contextualización permite distinguir entre:
“La máquina funciona diferente porque las condiciones han cambiado”
y
“La máquina funciona diferente porque algo está comenzando a deteriorarse”.
Para el Machine Learning industrial, esa diferencia es crítica.
6. ¿Tenemos registrados los eventos que queremos predecir?
Imagine que disponemos de millones de datos de temperatura, vibración y corriente.
Ahora queremos desarrollar un modelo que anticipe una falla de rodamiento.
La pregunta será:
¿Podemos identificar en el histórico cuándo ocurrieron realmente las fallas de rodamiento?
Necesitamos relacionar los datos de operación con eventos reales.
Aquí adquieren importancia los registros de mantenimiento, órdenes de trabajo, alarmas, causas de paro, sustitución de componentes y observaciones de los técnicos.
Si una orden simplemente indica “máquina reparada”, aporta poca información.
Si registra componente, modo de falla, fecha, hora, causa y acción realizada, su valor para desarrollar modelos aumenta considerablemente.
Los requisitos cambian según el enfoque. Un proyecto de detección de anomalías puede estudiar desviaciones respecto al comportamiento habitual sin disponer de todas las fallas etiquetadas.
Sin embargo, detectar una anomalía no equivale a confirmar una falla ni a predecir cuánto tiempo queda antes de que ocurra. La alerta necesita validación y contexto técnico.
Por eso, debe definirse desde el inicio qué resultado se busca: detectar un comportamiento inusual, identificar un tipo de falla o estimar un evento futuro.
7. ¿Podemos convertir una predicción en una acción?
Esta puede ser la pregunta más importante de todas.
Supongamos que el modelo detecta:
“Existe una anomalía creciente en el motor de la línea 3.”
¿Qué ocurre después?
Si nadie recibe la alerta, nadie la interpreta o no existe un procedimiento para actuar, el modelo tendrá poco impacto sobre el negocio.
El Machine Learning genera valor cuando entra en el proceso de decisión.
Una implementación industrial debería definir:
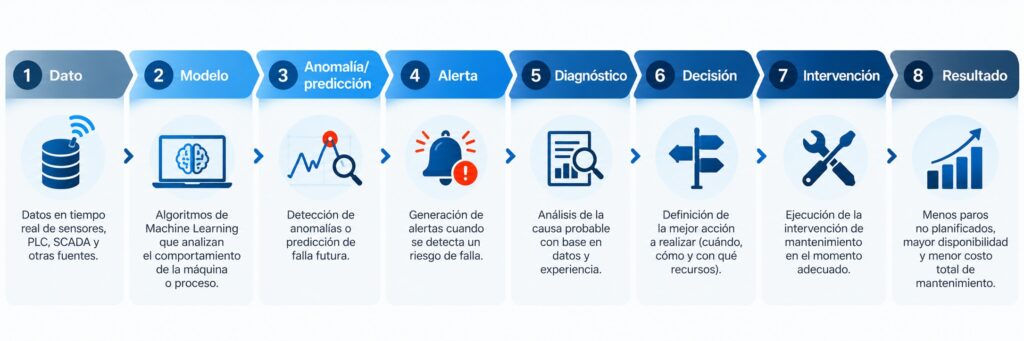
Por ejemplo:
Si se detecta una degradación suficientemente pronto, mantenimiento puede inspeccionar el equipo, validar el diagnóstico, preparar el repuesto y programar la intervención durante una ventana planificada.
El resultado que interesa no es que el algoritmo alcance una métrica técnica determinada.
El resultado es:
menos paros no planificados, mayor disponibilidad, reducción de pérdidas productivas, menor mantenimiento de emergencia o mejora del proceso.
Entonces, ¿está su planta preparada para Machine Learning?
Una planta industrial no necesita responder “sí” perfectamente a las siete preguntas.
De hecho, el diagnóstico puede revelar que todavía faltan datos, sensorización, históricos o una mejor clasificación de los eventos de mantenimiento.
Eso también es un resultado útil.
La preparación para Machine Learning industrial puede entenderse como una secuencia:
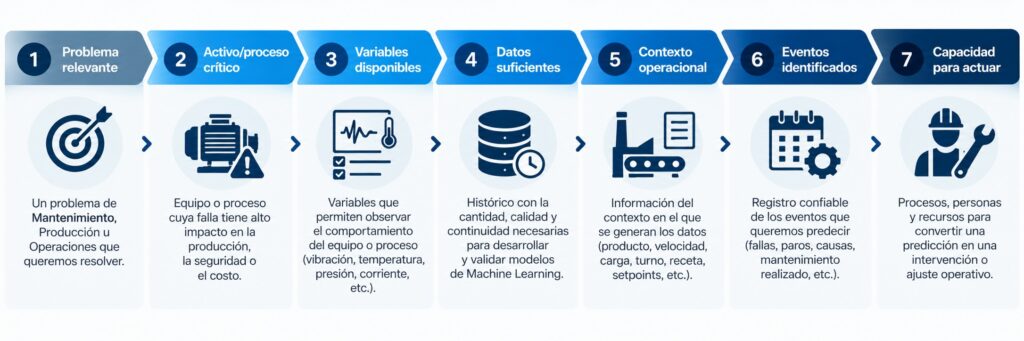
Si faltan los primeros elementos, probablemente sea prematuro comenzar desarrollando modelos.
Si existen, ya hay una base sobre la que evaluar técnicamente un caso de uso.
Por eso, el primer proyecto no debería ser necesariamente: “Implementemos Machine Learning en toda la planta.”
Puede ser mucho más concreto:“Identifiquemos un problema crítico, comprobemos qué datos tenemos y evaluemos si podemos anticiparlo.”
¿Por dónde empezar?
Antes de invertir en más sensores, software o modelos predictivos, identifique dónde existe realmente una oportunidad.
La Matriz de Criticidad vs. Cobertura de Monitoreo de Carsan Technology permite analizar junto con Mantenimiento y Operaciones qué activos son críticos, qué nivel de monitoreo tienen actualmente, dónde existen brechas y cuáles podrían ser candidatos iniciales para mantenimiento predictivo y Machine Learning.
Carsan Technology cuenta con un equipo especializado en automatización industrial, digitalización y análisis de datos, integrando tecnologías como PLC, drives, sistemas de control, software, Business Intelligence y Data Science para resolver problemas específicos de las operaciones industriales. Puede conocer más sobre Carsan Technology y su experiencia tecnológica.
Antes de preguntarse qué modelo de Machine Learning necesita su planta, responda una pregunta más sencilla:
¿Tenemos un problema suficientemente importante, los datos adecuados para entenderlo y capacidad para actuar cuando el modelo detecte algo?
Si la respuesta es sí, probablemente exista un buen punto de partida.
Si todavía no lo sabe, empiece identificando sus activos críticos, las brechas de monitoreo y los datos disponibles.
El objetivo no es implementar Machine Learning.
El objetivo es utilizar Machine Learning donde pueda mejorar una decisión y generar un resultado operativo y económico medible.
 Monitoreo de condición de maquinaria en líneas metalmecánicas: cómo detectar una falla antes de que detenga la producción

Deja un comentario